定義迭代 $t$ 次目標函數為
$$\begin{align*} \mathcal{L}^{(t)} = \sum_{i=1}^{n} l(y_i, \hat{y}_i^{(t-1)} + f_t(\mathbf{x}_i)) + \Omega(f_t) \end{align*}$$where
- $\Omega(f) = \gamma T + \frac{1}{2}\lambda \|\mathbf{w}\|^2$
- loss function $l(y_i, \hat{y}_i^{(t-1)})$ measures the difference between $y_i, \hat{y}_i^{(t-1)}$
- $\Omega(f_t)$ is the penalty
- leaf weight $\mathbf{w}=(w_1, ,\cdots, w_T)$
- sample index $i=1, \cdots, n$
- tree index $t=1, \cdots, K$
- leaf index $j=1, \cdots, T$
- $\lambda, \gamma$ are parameters
目的
根據舊模型造成的殘差,逐個增加分類樹,在迭代$t$ 次建立能讓當下目標函數降最多的分類樹 $f_t$
$$\begin{align*}\arg\min_{f_t} \mathcal{L}^{(t)}\end{align*}$$做法
當 loss function $l$太過複雜,權重$w$ 無法導出解析解。因此統一使用泰勒展開,逼近目標函數求解
$$\begin{align*}\mathcal{L}^{(t)} \simeq \sum_{i=1}^{n} [l(y_i, \hat{y}^{(t-1)}) + g_i f_t(\mathbf{x}_i) + \frac{1}{2} h_i f_t^2(\mathbf{x}_i)] + \Omega(f_t)\end{align*}$$where
$$\begin{align*}g_i = \partial_{\hat{y}^{(t-1)}} l(y_i, \hat{y}^{(t-1)}) \text{ and } h_i = \partial_{\hat{y}^{(t-1)}}^2 l(y_i, \hat{y}^{(t-1)})\end{align*}$$第$t$ 次迭代,前面 $t-1$ 個樹結構已經決定,$l(y_i, \hat{y}^{(t-1)})$ 視作常數
$$\begin{align*}\tilde{\mathcal{L}}^{(t)} = \sum_{i=1}^{n} [g_i f_t(\mathbf{x}_i) + \frac{1}{2} h_i f_t^2(\mathbf{x}_i)] + \Omega(f_t)\end{align*}$$當樣本 $\mathbf{x}_i$ 歸類在 $j$ 葉子, $f_t(\mathbf{x}_i)=w_j$
$$\begin{align*} \tilde{\mathcal{L}}^{(t)} &= \sum_{i=1}^{n} [g_i f_t(\mathbf{x}_i) + \frac{1}{2} h_i f_t^2(\mathbf{x}_i)] + \gamma T + \frac{1}{2}\lambda \sum_{j=1}^{T} w_j^2 \\ &= \sum_{j=1}^{T} [(\sum_{i \in I_j} g_i)w_j + \frac{1}{2}(\sum_{i \in I_j} h_i + \lambda)w_j^2] + \gamma T \end{align*}$$微分找出極小值發生點,亦即 $j$ 葉子的最佳權重
$$\begin{align*}w_j^* = -\frac{\sum_{i \in I_j} g_i}{\sum_{i \in I_j} h_i + \lambda}\end{align*}$$$w_j^*$ 帶入step3,得到 score function
$$\begin{align*}\tilde{\mathcal{L}}^{(t)}(q) = -\frac{1}{2} \sum_{j=1}^{T} \frac{(\sum_{i \in I_j} g_i)^2}{\sum_{i \in I_j} h_i + \lambda} + \gamma T\end{align*}$$score function表示當前結構下的最小總成本,score 越低越好
剪枝(pruning)
分裂前,葉子 $j$ 的 score
$$\begin{align*} -\frac{1}{2}\frac{(\sum_{i \in I_j} g_i)^2}{\sum_{i \in I_j} h_i + \lambda} + \gamma \end{align*}$$分裂後,葉子 $j$ 生出兩個葉子,score 變成
$$\begin{align*}-\frac{1}{2} \left[\frac{(\sum_{i \in I_L} g_i)^2}{\sum_{i \in I_L} h_i + \lambda} + \frac{(\sum_{i \in I_R} g_i)^2}{\sum_{i \in I_R} h_i + \lambda}\right] + 2\gamma\end{align*}$$定義 gain= 分裂前的 score- 分裂後的 score
$$\begin{align*}\mathcal{gain} = \frac{1}{2} \left[ \frac{(\sum_{i \in I_L} g_i)^2}{\sum_{i \in I_L} h_i + \lambda} + \frac{(\sum_{i \in I_R} g_i)^2}{\sum_{i \in I_R} h_i + \lambda} - \frac{(\sum_{i \in I} g_i)^2}{\sum_{i \in I} h_i + \lambda} \right] - \gamma\end{align*}$$如果分裂後 score 減少,$i.e. \ gain>0$,該次分裂對於降低 loss+penalty 是有益的。因此,只需修剪那些 $gain\leq 0$ 的分支。pruning 目的是清除部分分支,避免 ovefitting,常見以下兩種
- Pre-stopping(預剪枝):當節點的 $\text{gain} \le 0$,就停止繼續向下分支
- Post-pruning(後剪枝):為了避免第一次切分表現不好,但第二次切分讓 loss 大幅度降低,這樣的情況。會先讓樹長到最大深度
max_depth,再由下往上檢查,並遞迴剪去 $\text{Gain} < 0$ 的枝葉
xgboost 使用 Post-pruning
處理缺失值
- 分別用左分支、右分支歸類所有的 missing data,看哪個 score 較高,決定所有的 missing data 該使用哪個分支
參數
- 隨著樹的數量增加, training set 的 loss 會陡降後趨於平緩;Validation Set loss 則是下降後,因為樹的數量過多造成的雜訊,loss 回升
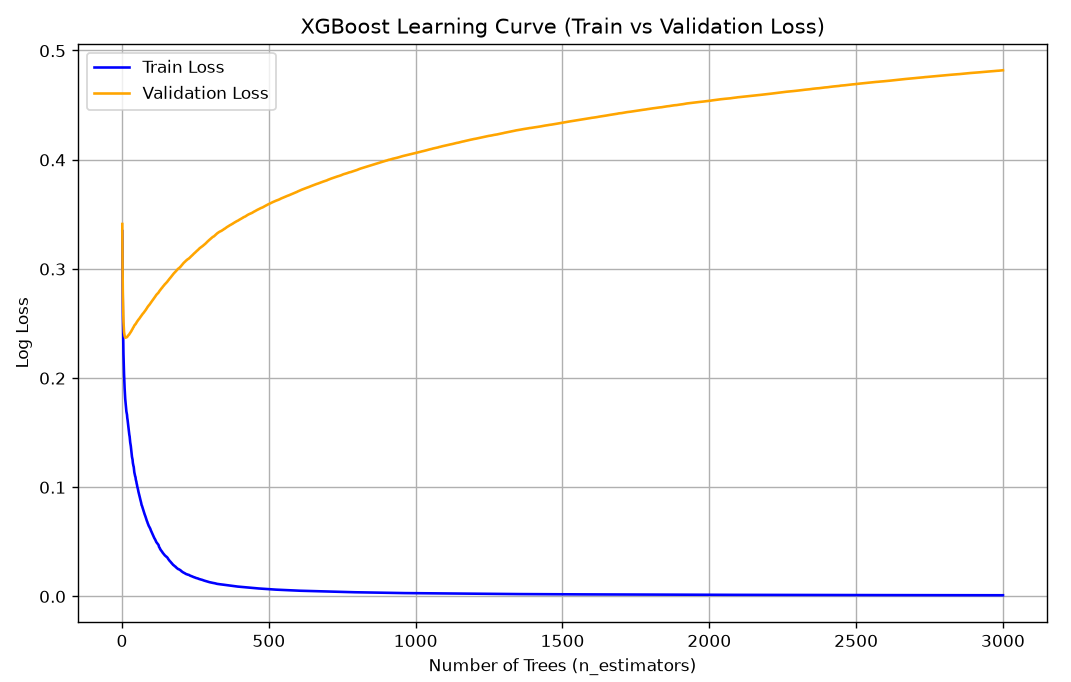
- 如何控制樹的數量過多的情況?
early_stopping_rounds= N ,表示當連續 N 輪,Validation loss 沒有突破歷史新低,停止增加樹。或是用n_estimators=N 限制樹的總數量為 N- 如何防止 overfitting?
reg_lambda,reg_alpha,gamma數字調大,增加樹的數目懲罰效果;或是colsample_bytree,subsample調小learning_rate$\eta$ 調小,可減少新建立的樹對預測的影響 $$\begin{align*}\hat{y}_i^{(t)}=\hat{y}_i^{(t-1)} + \eta f_t(\mathbf{x}_i)\end{align*}$$
缺點
- 用泰勒二階計算 loss+penalty 的近似值,因此優化的函數並不是原本的目標函數,有些誤差
- 想得到全域最佳解,必須列出所有可能結構,逐一比較,是個NP hard問題,退而求其次,限制樹的數量並使用 Post-pruning 剪枝
| |